GPT-6.1 Sol: premiera, benchmarki i koszt pracy z nowym modelem OpenAI
GPT-6.1 Sol zbliża się do Astry przy niższych stawkach API. Analizujemy benchmarki OpenAI, Artificial Analysis i Vals AI, dostępność, ceny i ograniczenia modelu.
GPT-6.1 Sol jest już dostępny. Dla osób śledzących premiery modeli najważniejsze jest nie samo oznaczenie 6.1, lecz to, czy nowy Sol pozwala wykonywać trudniejsze zadania w akceptowalnym czasie i budżecie. Artykuł łączy dane producenta z niezależnymi pomiarami oraz przykładami, które pomagają ocenić sens zmiany modelu.
Informacje i cenniki sprawdziliśmy 5 października 2026 r. Wyniki pochodzą z przywołanych ewaluacji; TreffikAI nie przeprowadził własnych testów wydajności GPT-6.1 Sol. Wykres jest naszym opracowaniem danych Artificial Analysis.
Premiera GPT-6.1 Sol: kiedy i gdzie można go używać?
Changelog API OpenAI potwierdza premierę 29 września 2026 r. Identyfikator modelu to gpt-6.1-sol. Zmiana dotyczy konkretnego wariantu Sol; nie oznacza automatycznie premiery nowych wersji wszystkich modeli z rodziny GPT-6.
Według aktualnej dokumentacji dostępności wdrożenie obejmuje Plus, Pro, Business, Enterprise i Edu w Codex oraz ChatGPT Work. Model nie jest dostępny w zwykłym trybie Chat. Free i Go nie są objęte dostępem premierowym. W Enterprise i Edu administrator musi go włączyć; znaczenie mają także używany klient i etap udostępniania.
Standard i Fast są wymienione jako tryby dostępne przy premierze. Dokumentacja nadal opisuje Ultrafast dla GPT-6.1 Sol jako funkcję nadchodzącą. Nie traktujemy zapowiedzi szybszego wariantu jako potwierdzenia jego dostępności na każdym koncie.
Dostęp w subskrypcji i rozliczenie API to osobne kwestie. Nazwa modelu widoczna w artykule nie mówi, ile zadań wykona konkretne konto przed wykorzystaniem swojego limitu.
Benchmarki OpenAI: co potwierdzają dane premierowe?
Komunikat OpenAI przedstawia Sol 6.1 jako model zbliżający się do Astry. Wybrane różnice względem GPT-6 Sol:
| Benchmark | Zmiana według OpenAI | Warunek porównania |
|---|---|---|
| DeepSWE v1.1 | +6,4 pkt proc. | względem najlepszego wyniku poprzednika, przy niższym wysiłku nowego modelu |
| AutomationBench 1.0.6 | +4,8 pkt proc. | oba modele przy Medium |
| OSWorld 2.0 | +7,0 pkt proc. | oba modele przy Max; offline, punktacja częściowa, v2026.08.08 |
| Terminal-Bench Science 0.1 | ponad dwukrotny wynik | oba modele przy Max |
To dane producenta z jego środowiska badawczego lub API. Wyniki konkurentów w tej publikacji pochodzą z publicznych raportów. Porównanie przy innym wysiłku, systemie narzędzi lub budżecie nie jest kontrolowanym testem jednej zmiennej.
Nasza interpretacja: poprawa w pracy nad kodem uzasadnia próbę na własnym repozytorium. Nie dowodzi jednak, że model będzie równie dobry w każdym języku, z każdą konfiguracją testów i w każdej organizacji. Benchmark obsługi komputera również nie odpowiada wprost na pytanie, czy agent poradzi sobie z konkretnym panelem księgowym.
Nie sumujemy tych różnic w jeden procent „wzrostu inteligencji”. Każdy test ma inne zadania i sposób punktowania. Podstawy takich porównań wyjaśniamy w haśle ewaluacja modelu.
Niezależne benchmarki Artificial Analysis: GPT-6.1 Sol kontra GPT-6 Sol
Poniżej dane z porównania Artificial Analysis, dla obu modeli przy High, odczytane 5 października. Zachowujemy zaokrąglenia widoczne w źródle.
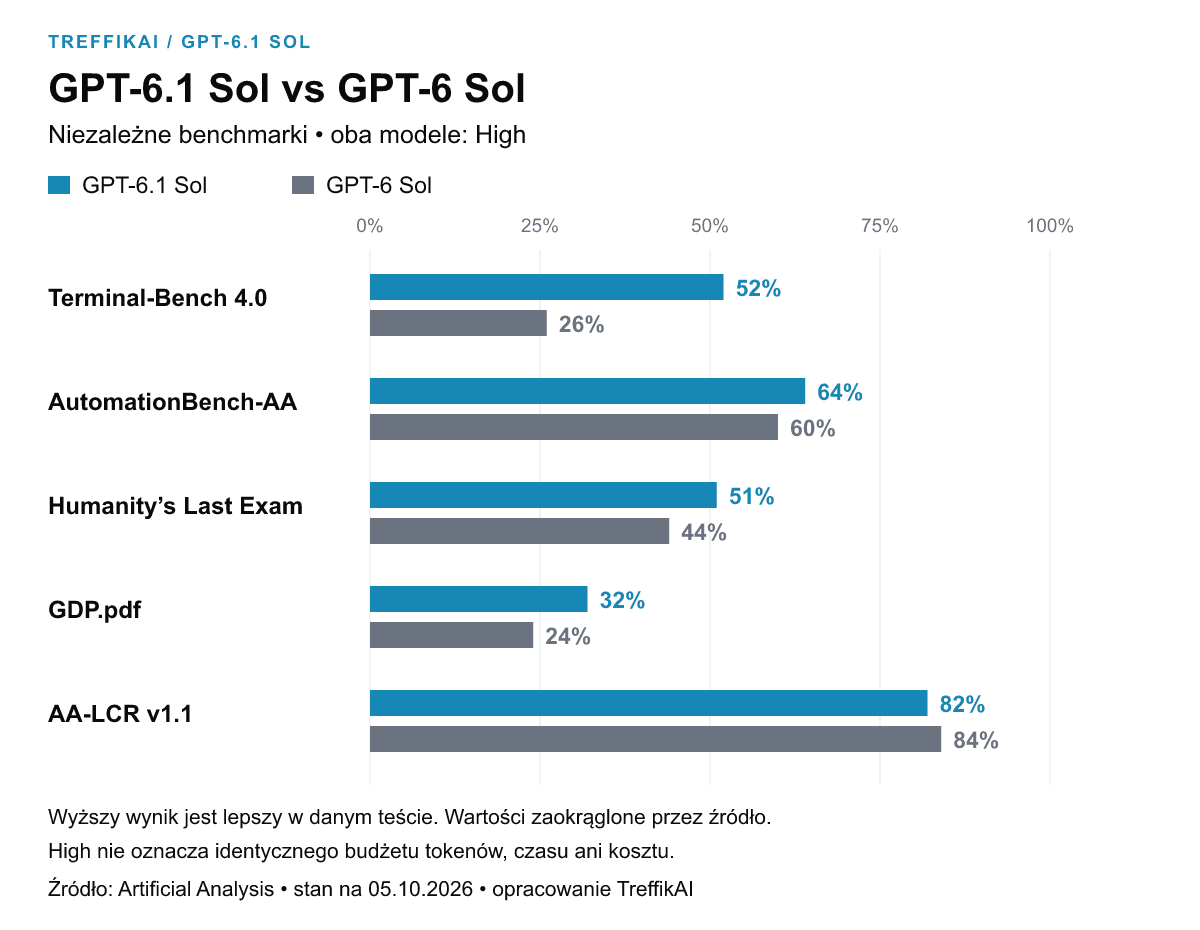
| Test lub wskaźnik | GPT-6.1 Sol, High | GPT-6 Sol, High |
|---|---|---|
| Intelligence Index | 50 | 42 |
| Terminal-Bench 4.0 | 52% | 26% |
| AutomationBench-AA | 64% | 60% |
| Humanity's Last Exam | 51% | 44% |
| GDP.pdf | 32% | 24% |
| AA-LCR v1.1 | 82% | 84% |
Intelligence Index jest wynikiem indeksu, a nie odsetkiem poprawnych odpowiedzi. Dlatego nie umieszczamy go na procentowej osi wykresu. Z kolei identyczna etykieta High nie gwarantuje identycznego zużycia tokenów, czasu ani pieniędzy.
W tym zestawieniu największą różnicę widać w Terminal-Bench. Jednocześnie wynik AA-LCR przypomina, że nowa wersja nie musi wygrywać w każdym teście. Dla projektu analizującego długie dokumenty sam wzrost średniego indeksu nie wystarcza do podjęcia decyzji.
AutomationBench-AA i test AutomationBench z komunikatu OpenAI należą do różnych ewaluacji. Nie odejmujemy wyniku z jednej publikacji od wyniku z drugiej i nie przedstawiamy takiej różnicy jako poprawy modelu.
Co pokazują testy Vals AI?
Drugi niezależny punkt odniesienia to karta GPT-6.1 Sol w Vals AI. Poniżej wybrane wyniki z 5 października; karta podaje domyślny poziom Max, z możliwością innych parametrów dla poszczególnych testów.
| Benchmark Vals AI | Wynik | Niepewność podana przez źródło |
|---|---|---|
| Terminal-Bench 4.0 | 55,05% | ±1,82 |
| Terminal-Bench Science | 52,86% | ±6,01 |
| Code Migration | 65,12% | ±4,36 |
| Finance Agent v2 | 52,03% | ±0,31 |
| Legal Research Bench | 38,46% | ±3,38 |
Te liczby opisują różne zestawy zadań. Nie oznaczają, że użytkownik otrzyma dokładnie taki odsetek poprawnych odpowiedzi podczas codziennej pracy. Nie tworzymy też średniej z pięciu wierszy, ponieważ taka średnia nie miałaby jasno określonego znaczenia.
Obecność wyników z migracji kodu, finansów i researchu prawnego jest użyteczna przy planowaniu własnych prób. Zespół może wybrać zadania z dziedziny, w której rzeczywiście pracuje, zamiast testować model wyłącznie na zagadkach. Wynik w benchmarku branżowym nie zastępuje sprawdzenia odpowiedzi przez osobę znającą dane i kryteria poprawności.
Kod, dokumenty i aplikacje: jak przełożyć premierę na praktykę?
W programowaniu sensowna próba obejmuje cały cykl: od odtworzenia błędu przez zmianę kodu po uruchomienie odpowiednich testów. Sama poprawna sugestia w oknie rozmowy to za mało. Warto sprawdzić, czy model rozumie istniejące konwencje, ogranicza zmianę do potrzebnego zakresu i potrafi wykazać, że naprawa działa.
Przy analizie dokumentów dobrym zadaniem jest porównanie kilku raportów z odwołaniem do konkretnych stron i tabel. W zestawie testowym powinno znaleźć się także pytanie, na które materiały nie zawierają odpowiedzi. Dzięki temu mierzymy nie tylko wyszukiwanie faktów, lecz również reakcję na brak dowodu.
W pracy z aplikacjami sprawdzajmy stan końcowy: czy właściwy rekord został zapisany, czy arkusz zawiera poprawną formułę, czy eksport jest kompletny. Komunikat „gotowe” nie jest sam w sobie potwierdzeniem wykonania zadania. Taką pracę opisujemy szerzej w haśle agent AI.
Zdjęcie ilustracyjne: Alex Knight / Unsplash, Unsplash License. Nie przedstawia robota sterowanego przez GPT-6.1 Sol.
Nasza propozycja dla zespołu to niewielki zestaw powtarzalnych zadań z zachowanymi wejściami i jednoznacznym kryterium sukcesu. Do każdego wyniku dopiszmy czas, koszt, liczbę poprawek oraz to, czy człowiek musiał interweniować. Dopiero takie porównanie pokazuje, czy zmiana pomaga w danym procesie.
Okno kontekstu, obrazy i parametry modelu
Najważniejsze parametry z oficjalnej karty modelu:
| Parametr | GPT-6.1 Sol |
|---|---|
| Identyfikator API | gpt-6.1-sol |
| Okno kontekstu | 1 050 000 tokenów |
| Maksymalne wyjście | 128 000 tokenów |
| Granica wiedzy treningowej | 30 kwietnia 2026 r. |
| Wejście / wyjście | tekst i obrazy / tekst |
| Natywne audio / wideo | nieobsługiwane |
| Fine-tuning | nieobsługiwany |
Duże okno kontekstu to pojemność, a nie gwarancja trafnej interpretacji całej zawartości. Przed przesłaniem pełnego archiwum warto określić pytanie, oczekiwany format wyniku i dokumenty, które naprawdę są potrzebne. Pozwala to także łatwiej zweryfikować, skąd model wziął odpowiedź.
Data graniczna wiedzy nie jest datą ostatniej informacji, którą model może znaleźć za pomocą narzędzia. Przy pytaniach o bieżące wydarzenia potrzebuje aktualnego źródła. Obsługa obrazu na wejściu również nie oznacza natywnego generowania zdjęć: do tego służy osobne narzędzie.
Ceny API: ile kosztuje Sol 6.1 w porównaniu z Astrą?
Stawki Standard w USD za milion tokenów, według oficjalnego porównania modeli, dla żądań do 272 tys. tokenów wejściowych:
| Model | Wejście | Trafienie w cache | Zapis cache | Wyjście |
|---|---|---|---|---|
| GPT-6.1 Sol | 2,00 USD | 0,10 USD | 2,50 USD | 10,00 USD |
| GPT-6 Sol | 2,00 USD | 0,20 USD | 2,50 USD | 10,00 USD |
| GPT-6 Astra | 10,00 USD | 1,00 USD | 12,50 USD | 50,00 USD |
| GPT-6 Luna | 0,10 USD | 0,01 USD | 0,125 USD | 0,50 USD |
Nasze obliczenie: 100 tys. niebuforowanych tokenów wejściowych i 10 tys. tokenów wyjściowych, łącznie z rozumowaniem, kosztuje w Sol 6.1 0,30 USD. Przy identycznych liczbach tokenów Astra kosztuje 1,50 USD. To porównanie rachunku za tokeny, nie wynik pomiaru kosztu rozwiązania problemu.
Jeżeli całe 100 tys. tokenów wejścia kwalifikuje się do trafienia w cache, analogiczny rachunek Sol 6.1 wynosi 0,11 USD, bez kosztu utworzenia pamięci podręcznej. Nie oznacza to, że każda długa rozmowa automatycznie korzysta z tej stawki. Mechanizm ponownego użycia kontekstu trzeba uwzględnić w projekcie aplikacji.
Dokumentacja cen określa dodatkowe warunki: powyżej 272 tys. tokenów wejścia mnożniki obejmują całe żądanie — 2× dla wejścia i cache oraz 1,5× dla wyjścia. Fast kosztuje 2× Standard, Batch i Flex mają stawki o 50% niższe, a przetwarzanie regionalne dodaje 10% tam, gdzie jest oferowane. Dochodzą ewentualne opłaty za narzędzia.
W budżecie produkcyjnym warto policzyć także powtórzenia, niedokończone zadania i czas weryfikacji. Tańszy token nie pomoże, jeżeli rezultat trzeba wielokrotnie poprawiać; z drugiej strony większy wysiłek może się opłacić, jeśli zmniejsza liczbę prób.
Integracja API: zgodność, reasoning i narzędzia
Przewodnik GPT-6 wskazuje pięć poziomów reasoning.effort: low, medium, high, xhigh, max. Domyślny jest medium; none i minimal nie są obsługiwane przez Sol 6.1.
Wywoływanie narzędzi wymaga Responses API. Chat Completions pozostaje dostępne dla żądań bez narzędzi. Changelog wymienia również obsługę Multi-agent w fazie beta.
Poniżej minimalny przykład treści żądania do POST /v1/responses, zgodny z dokumentacją. To przykład konfiguracji, a nie zapis testu wykonanego przez redakcję:
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "medium" },
  "input": "Porównaj dostarczone raporty. Wskaż źródła liczb i brakujące informacje."
}
Przy zmianie poprzedniego Sola najpierw sprawdźmy parametry, narzędzia i sposób oceniania wyniku. Jeżeli aplikacja używała none, samo zastąpienie identyfikatora modelu nie wystarczy. Przydatnym uzupełnieniem jest nasz poradnik jak pisać prompty, zwłaszcza ustalanie oczekiwanego wyniku i ograniczeń zadania.
Błędy rzeczowe i bezpieczeństwo: czego benchmarki nie gwarantują?
Dodatek do system card opisuje m.in. halucynacje, prompt injection i respektowanie ograniczeń. OpenAI traktuje zdolności modelu jako Critical w cyberbezpieczeństwie i High w biologii oraz chemii. To klasyfikacja zdolności w ramach producenta; nie jest certyfikatem bezbłędności.
W teście trudnych pytań OpenAI przy Low udział odpowiedzi z co najmniej jednym błędem spadł z 11,4% do 7,7%. Próby pochodziły z rozmów, w których wcześniej zgłoszono błąd; nie reprezentują zwykłego użytkowania. Nie wyprowadzamy z tego ogólnego „poziomu halucynacji” dla wszystkich zastosowań.
Praktyczny test powinien uwzględniać niepełne dane, awarię narzędzia i polecenie znajdujące się w cudzym dokumencie. Sprawdzajmy, czy model zgłasza problem i przestrzega zakresu zadania. Poprawna odpowiedź w prostym przykładzie nie dowodzi odporności całego procesu na nieoczekiwane sytuacje.
W automatyzacji warto zachować możliwość przeglądu wyniku przed wysłaniem lub opublikowaniem go. Sposób kontroli powinien wynikać z konkretnej czynności: inaczej ocenia się robocze podsumowanie, a inaczej zmianę danych w działającym systemie.
Czy warto przejść na GPT-6.1 Sol?
Nasza ocena: GPT-6.1 Sol zasługuje na porównanie z poprzednikiem w zadaniach wymagających pracy nad kodem, dokumentami i aplikacjami. Najbardziej przydatnym argumentem za próbą jest połączenie niezależnie widocznych postępów z zachowaniem standardowych stawek wejścia i wyjścia Sola.
Nie zakładamy, że automatycznie zastąpi Astrę. Dla najtrudniejszych zadań warto porównać oba modele na tych samych materiałach i uwzględnić jakość wyniku po weryfikacji. Kontekst pozycjonowania flagowego modelu opisuje nasz artykuł o GPT-6 Astra; jego dane cenowe odnoszą się do daty tamtej publikacji.
Przed decyzją o migracji odpowiedzmy na cztery pytania:
- Czy wynik spełnia wcześniej ustalone kryterium poprawności?
- Ile kosztuje zakończone i zaakceptowane zadanie, z uwzględnieniem powtórzeń?
- Jak długo użytkownik czeka na użyteczny rezultat?
- Ile pracy kontrolnej nadal wykonuje człowiek?
Jeżeli zmiana poprawia te mierniki w rzeczywistych zadaniach, jest dobrym powodem do wdrożenia. Sam numer wersji i pojedyncza pozycja w rankingu pozostają słabszym argumentem niż sprawdzony wynik własnego procesu.
(Źródła: dokumentacja OpenAI i przywołane ewaluacje OpenAI, Artificial Analysis oraz Vals AI. Miniatura: BoliviaInteligente / Unsplash; zdjęcie w treści: Alex Knight / Unsplash; licencja obrazów. Wykres: opracowanie TreffikAI.)